很多企业的资料并不缺,缺的是一种可靠的使用方式:制度散在网盘里,产品说明有多个版本,项目经验留在聊天记录中。员工即使找到了文件,也需要判断内容是否过期、是否适用于当前问题。企业知识库要解决的,正是从“存得下”到“找得到、看得懂、能核对”的距离。
一、先定义问题,再选择模型
RAG,即检索增强生成,通常先根据问题从知识源中找出相关材料,再把这些材料作为上下文交给模型组织答案。它能让回答利用企业自己的资料,但不会天然保证答案正确,也不能代替资料治理和业务判断。
起步时,建议只选一个边界清楚的场景,例如内部制度查询、产品资料检索或售后文档辅助阅读。明确谁在使用、需要哪些资料、答案怎样被核对,以及哪些问题必须转交人工。这些约束会直接影响检索方式、部署方案和验收标准。
二、文档治理决定知识库的基础质量
把文件批量上传并不等于完成知识建设。扫描件可能存在 OCR 识别错误,表格可能在解析后丢失行列关系,同一制度的多个版本也可能互相冲突。进入索引前,应先检查文件的可读性、适用范围和更新状态。
- 为资料记录来源、负责人、版本、更新时间和访问范围。
- 依据标题、章节和语义边界切分内容,尽量保留表格标题、单位和上下文。
- 保留文档与内容片段的稳定标识,方便回答引用和后续更新。
- 建立资料下线与索引清理机制,避免旧版本、已撤回文档继续参与回答。
三、权限必须进入检索链路
如果不同部门、项目或客户的数据需要隔离,权限就不能只体现在页面上。检索服务应使用可信的登录身份和租户信息,约束可搜索的数据范围。即使向量召回或缓存能够命中某段资料,也必须在送入模型前完成授权检查。
引用链接同样需要校验权限。用户能看到某个答案,不代表他可以下载原始文件;共享回答、会话记录、搜索缓存和日志也应沿用相应的数据边界。不要把未授权材料先送给模型,再指望它自行隐藏。
四、从“相似内容”走向“可用证据”
向量检索适合处理语义近似的问题,关键词检索更擅长命中产品型号、合同编号和专有名称。是否采用混合检索,应结合实际问法与资料特点验证,而不是默认堆叠所有检索组件。
召回后,可以通过重排、去重和上下文组织,把真正相关的证据交给模型。需要关注的问题包括:资料是否仍有效,片段之间是否冲突,关键限定条件是否被截断,以及引用能否准确指向支持结论的位置。
五、让答案可以核对,也允许系统说不知道
回答应尽量区分原文事实、基于资料的归纳和仍需确认的信息。引用不是装饰:它应该帮助用户回到具体文档或片段,检查答案是否有依据。多个来源存在冲突时,应说明冲突,不能悄悄替企业作出制度解释。
当证据不足、问题超出资料范围或涉及敏感决策时,系统应说明限制,给出查阅入口或转人工路径。还需要将检索材料视为数据,防止文档中的恶意指令影响系统规则或工具调用。
六、用真实问题建立评估与更新闭环
评估集应来自实际使用中的典型问题,并标注参考材料和可接受答案。既要覆盖能回答的问题,也要包含无答案、旧版本冲突、权限不足和表格理解等情况。只挑容易答对的问题,会掩盖上线后的主要风险。
- 检索质量:能否找到关键证据,是否混入无关内容。
- 回答质量:事实是否有依据,引用是否支持结论,是否遗漏限制条件。
- 权限与安全:能否阻止跨部门、跨租户和过期授权的数据访问。
- 运行体验:记录响应时间、调用成本和失败类型,再确定改进优先级。
七、从一个可验证的场景开始
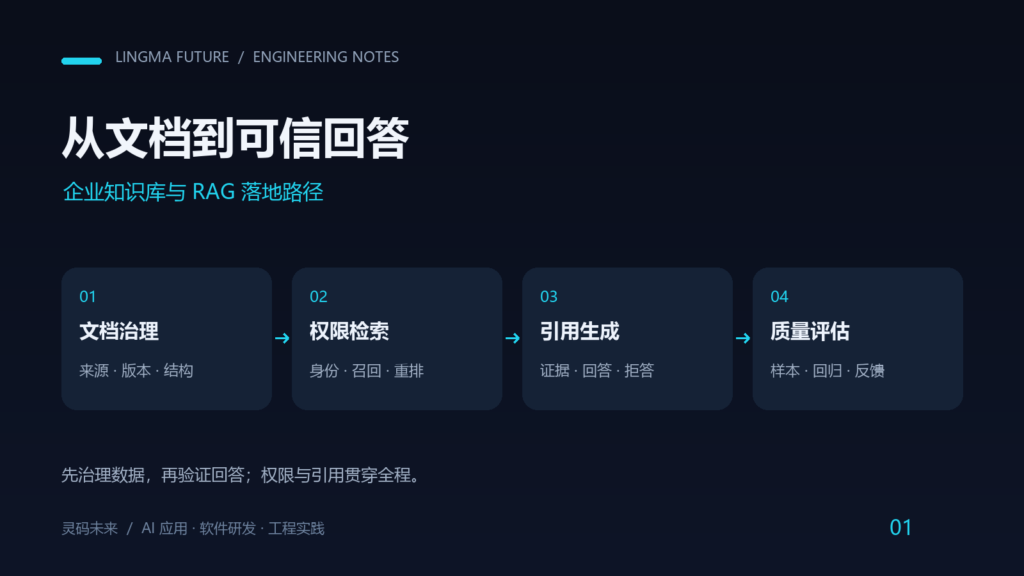
比较稳妥的实施路径是:选定资料范围,完成治理与权限映射,建立检索和引用能力,再用真实问题评估。达到明确的验收条件后,再逐步扩展数据源、用户范围和业务流程。知识库不是一次性导入项目,而是一套需要有人负责更新的知识服务。
如果你正在梳理企业资料与问答场景,可以继续了解AI 大模型应用开发和企业知识库与 AI 检索解决方案。沟通时,带上资料样例、权限边界和实际问题,往往比先比较模型参数更有帮助。